باحثون يطورون نظاماً روبوتياً يستكشف الأشياء بفعالية لتعلم خصائصها
يستخدم نظام ROMA نماذج لغوية ضخمة لتحديد الإجراءات الجسدية اللازمة، مثل اللمس أو الرفع، لفهم طبيعة الأشياء.
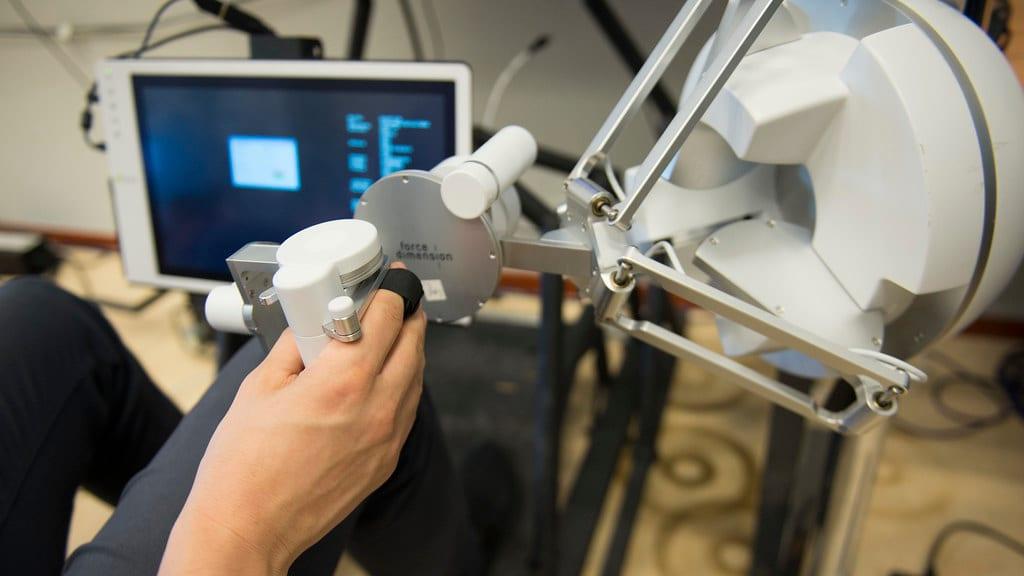
يستكشف البشر العالم بشكل طبيعي عن طريق لمس الأشياء وهزها عندما لا يتمكنون من معرفة ماهيتها بمجرد النظر إليها. يجلب نظام جديد يسمى ROMA هذه العملية النشطة إلى الروبوتات من خلال دمج الرؤية والصوت واللمس واستشعار القوة.
صمم الباحثون ROMA كحلقة استدلال تستخدم نماذج لغوية ضخمة لمعرفة المعلومات المفقودة. يقرر النظام التفاعل الجسدي الذي سيقدم أفضل تغذية راجعة حسية، مثل دفع الشيء أو رفعه. بعد ذلك، يقوم النظام بتنفيذ الحركة وتحديث فهمه بناءً على ما يستشعره.
يدمج ROMA الرؤية والصوت واللمس واستشعار القوة في حلقة من الاستدلال والتفاعل والتغذية الراجعة.
لتحقيق ذلك، أنشأ الفريق مجموعة بيانات تسمى ROMI-2K. تحتوي هذه المجموعة على ما يقرب من 2000 غرض من العالم الحقيقي وتغطي 6 تفاعلات فيزيائية أساسية، حيث اقترنت كل منها ببيانات مستشعرات متزامنة. سمح هذا للفريق بتدريب النموذج على تقييم اللحظة التي يمتلك فيها أدلة كافية لتكوين فهم كامل.
تخيل أنك وضعت حاوية غامضة أمام روبوت. بدلاً من مجرد النظر إليها، قد يقرر الروبوت إمالتها لسماع ما إذا كان هناك شيء يهتز بداخلها أو الضغط عليها لتقدير مدى صلابتها. تساعد سلسلة الإدراك هذه الروبوت في حل المهام المعقدة التي يصعب على المراقبة البصرية البسيطة القيام بها بمفردها.
على الرغم من أن النظام يتعامل بشكل جيد مع المهام المعقدة والطويلة، إلا أنه يعتمد حالياً على واجهات فيزيائية محددة لتنفيذ تفاعلاته. لم يختبر الباحثون بعد أداء ROMA عند التعامل مع الأشياء الهشة أو الدقيقة التي تتطلب تحكماً دقيقاً في القوة يشبه اللمس البشري.
المصدر: arXiv cs.RO