وكيل ذكاء اصطناعي يضاعف سرعة التحكم في الاستقطاب بالفيزياء النووية
أبحاث من arXiv تُظهر أن نظام تعلم تعزيزي تفوّق على الضبط اليدوي في نظام APOLLO.
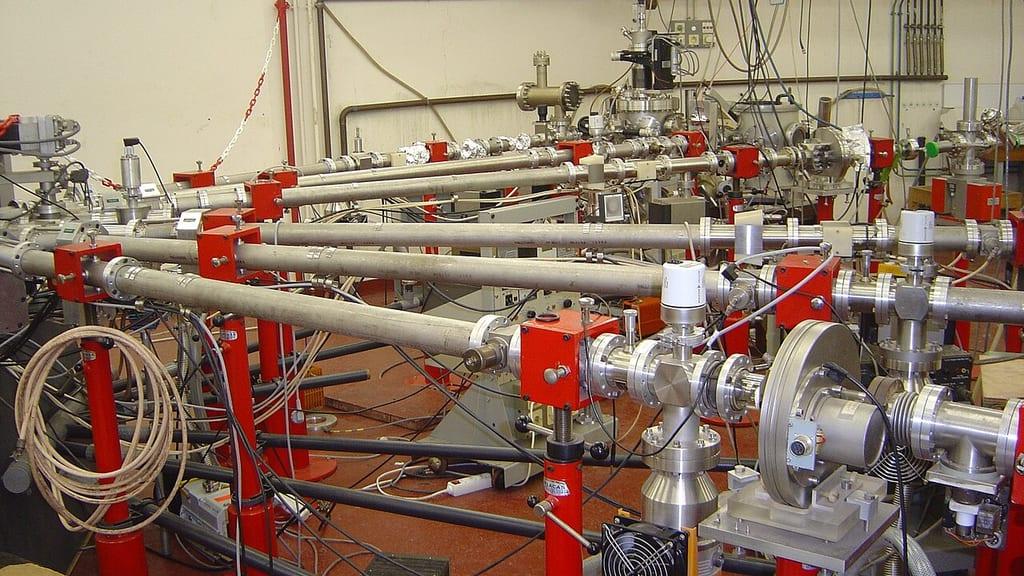
وكيل تعلم تعزيزي يضبط الآن أهداف الفيزياء النووية أسرع من الخبراء البشر. خضع النظام للاختبار على نظام الهدف المبرد APOLLO. وثّق هذا العمل في ورقة بحثية جديدة على arXiv.
في هذه التجارب، تحتاج الأهداف إلى ضبط مستمر للحفاظ على الاستقطاب. تلف الإشعاع وتغيرات المواد تجبر المشغّلين على تعديل ترددات الميكروويف يدوياً. هذه العملية بطيئة وتعتمد على التجربة والخطأ.
بنى الباحثون إطاراً قائماً على البيانات لأتمتة هذه العملية. استخدموا بيانات تشغيلية لتدريب نماذج بديلة. تتنبأ هذه النماذج بالاستقطاب بناءً على التردد والتيار والجرعة الإشعاعية.
تم تقييم نوعين من النماذج: شبكات متعددة الطبقات وتنظيم انحداري غاوسي. أثبتت النماذج الغاوسية موثوقية أكبر. وفّرت تقديرات موثوقة لعدم اليقين وكشفت عندما تقع البيانات خارج نطاق التدريب.
استخدم وكيل التعلم التعزيزي صيغة مكافأة تعتمد على الحد الأدنى للثقة. توازن هذه الطريقة بين تعظيم الأداء وإدارة عدم اليقين. تعلّم الوكيل العمل عبر عينات متعددة من الأهداف.
أظهرت النتائج تحسناً بنحو 2x مقارنة بإجراءات المشغّلين البشر. وجد النظام الإعدادات المثلى بكفاءة أكبر من الضبط اليدوي. هذا يشير إلى مكسب كبير في كفاءة التجارب.
يُبرز العمل قيمة تقدير عدم اليقين في مهام التحكم. كانت النماذج الغاوسية مفتاحاً لتحديد مناطق التشغيل الآمنة. سمح هذا للوكيل بالاستكشاف دون كسر النظام.
تم توحيد الإطار لبيئات المحاكاة. يسهّل هذا تطبيق الطريقة على أنواع أخرى من الأهداف. يُظهر العمل تطبيقاً عملياً للذكاء الاصطناعي في الفيزياء عالية الدقة.
لا يحدد المصدر المدة الدقيقة للتجارب. كما لا يوضح التكاليف المادية المحددة للمعدات. يُقاس التحسن مقارنة بإجراءات المشغلين وليس بالوقت المطلق.
المصدر: arXiv cs.AI