جي بي تي-6 أسترا يحقق 66.7% في اختبار جديد من أوبن إيه آي لقراءة نتائج المختبر الخام
بنت أوبن إيه آي وشركة ليجو BioBasicsBench، وهو 100 مهمة على صور الهلام وأطباق المستعمرات والمجهر، وما زال أفضل نموذج يخطئ بوضوح.
باختصار
الذكاء الاصطناعي قرأ أدلة المختبر ونال 66.7%
اختبرت أوبن إيه آي وليجو سبعة نماذج على 100 مهمة مخبرية. تصدر GPT-6 Astra بـ 66.7% درجات جزئية. وما زالت الأخطاء قائمة، منها عدّ زائد للمستعمرات بنسبة 12%.
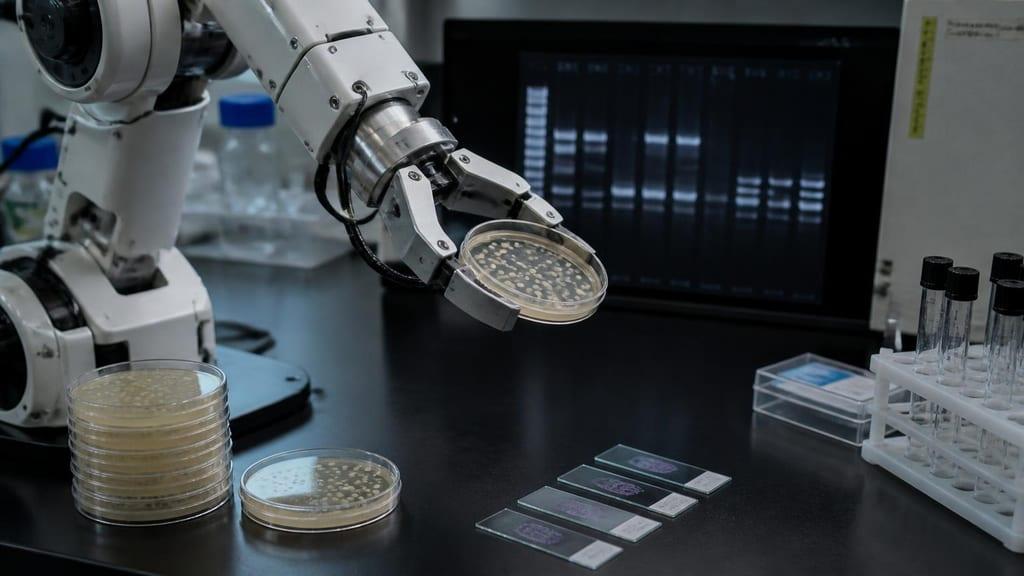
أطلقت أوبن إيه آي (OpenAI) وشركة ليجو (Ligo)، وهي شركة تقنية حيوية تركز على تصميم الإنزيمات، اختبار BioBasicsBench. هو مقياس من 100 مهمة يختبر كيف يقرأ وكلاء الذكاء الاصطناعي الأدلة الخام من تجارب المختبر الرطب. هذا ما يرد في منشور أوبن إيه آي، المؤرخ في 6 نوفمبر 2026 على صفحته، وفي مواقع متخصصة بأخبار الذكاء الاصطناعي.
يقول تقرير واحد إن الإعلان جرى في 4 نوفمبر. أي أن المصادر لا تتفق على التاريخ.
ما شكل المهام
يحصل الوكلاء على مواد مخبرية حقيقية: صور الهلام، وأطباق المستعمرات، والمجهر، وقراءات الأجهزة. وتنقسم المهام إلى خمسة مجالات: طرائق البروتين، والتصوير وقياس الخلايا، والقياس الكمي والمقايسات، وطرائق الحمض النووي، والاستنساخ الجزيئي.
راجع كل مهمة عالم من ليجو لم يكتبها، ثم عالم مخبري خارجي بدرجة دكتوراه، ثم مراجعة داخلية أخيرة.
الأرقام
اختبرت أوبن إيه آي سبعة نماذج، منها GPT-5.6 Sol وGPT-6.1 Sol وGPT-6 Astra. وشمل الاختبار 37 توليفة من النموذج ومستوى التفكير، مع خمس محاولات لكل مهمة.
عند أعلى مستوى تفكير، حصل GPT-6 Astra على متوسط 66.7% من الدرجات المتاحة. وحصل GPT-5.6 Sol على 43.8%.
يعتمد التقييم على درجات جزئية وفق معايير كتبها خبراء. لذلك لا يعني الرقم 66.7% نسبة التجارب التي سينجح فيها النموذج.
لماذا يهمك
تخيل مساعد مختبر ينظر إلى صورة طبق ويخبرك بما تفعله بعد ذلك. إن أخطأ في قراءتها ضاعت عليك أيام. هذا الاختبار يفحص تلك الخطوة: قراءة الدليل قبل اتخاذ القرار.
وتُظهر الإخفاقات التي توثقها الشركة حجم الخطر. منها عدّ زائد للمستعمرات بنسبة 12%. وفي مهمة تفاعل البوليميراز المتسلسل للمستعمرات، اختار النموذج الأفضل عينات خاطئة.
الحدود
تقول أوبن إيه آي إن ارتفاع الدرجات لا يعني بعد أن النماذج تتخذ أحكامًا مخبرية موثوقة. واختبرت نماذجها وحدها، ولا يوجد مقياس مرجعي لأداء البشر. ولا تذكر المصادر كيف سيكون أداء عالم مدرب على المهام نفسها.
المصادر
المصدر: OpenAI News