نموذجان صغيران علّم كل منهما الآخر التنبؤ باللغة والموسيقى والحمض النووي دون بيانات تدريب
أنجز جامعة تل أبيب وستانفورد النموذج التجريبي، وتحسنت تنبؤاته كلما زادت القدرة الحاسوبية المستخدمة في التدريب.
باختصار
ذكاء اصطناعي تعلّم التنبؤ بصفر بيانات تدريب
درّب نموذجان صغيران بعضهما. الأول يكتب برامج والثاني يتنبأ بمخرجاتها. في اختبارات اللغة والموسيقى والحمض النووي، **تحسّن التنبؤ مع زيادة الحوسبة**. لكنه **لا يعلّم حقائق العالم الحقيقي** وحده.
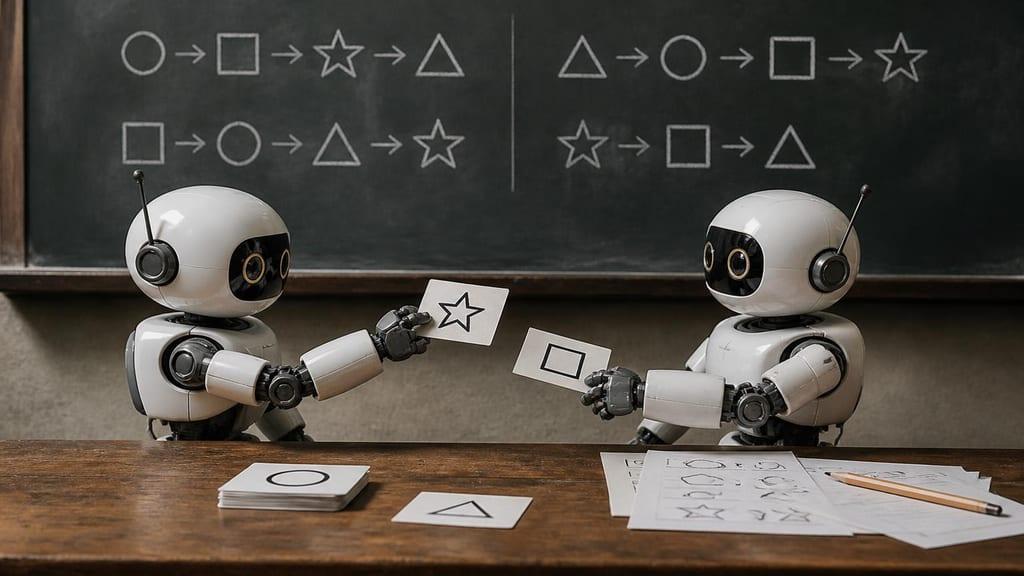
تعلّم نموذجان صغيران من الذكاء الاصطناعي التنبؤ بالقطعة التالية في أي سلسلة، دون أن يريا بيانات من العالم الحقيقي. يقف وراء العمل جامعة تل أبيب (Tel Aviv University) وجامعة ستانفورد (Stanford University)، وهو منشور في ورقة على موقع arXiv للأبحاث الأولية.
كيف يعمل
الفكرة أشبه بثنائي يعمل معًا. النموذج الأول يكتب برامج صغيرة، وكل برنامج يُخرج سلسلة من الرموز. النموذج الثاني، المتعلّم، يحاول تخمين الرمز التالي.
يُكافأ الكاتب حين ينتج سلاسل عند حدود قدرة المتعلّم. وكلما تحسّن المتعلّم صارت التمارين أصعب. يسمي المؤلفون ذلك منهجًا دراسيًا متكيفًا.
تخيّل معلمًا يضع كل اختبار جديد فوق مستواك الحالي بقليل. هذه هي الفكرة نفسها، دون أن يكتب إنسان الأسئلة.
ما الذي اختُبر
بعد التدريب، اختُبرت النماذج على اللغة والصور والصوت والموسيقى والشيفرة البرمجية وتسلسلات الحمض النووي. ولم يُستخدم أي منها في التدريب. ويصف الملخص ذلك باختبار نظيف لانتقال التعلّم.
النتيجة: تحسّن التنبؤ بشكل منتظم يمكن توقعه كلما زادت القدرة الحاسوبية المستخدمة في التدريب. ويذكر الملخص أيضًا أن النماذج أظهرت تعلّمًا من السياق، أي التقاط الأنماط من أمثلة تُعطى لحظة الاستخدام. كما اكتشفت متتاليات رياضية معروفة أثناء التدريب.
من أنجز العمل
أشرف على العمل الدكتور يوآف ليفين (Yoav Levine) من جامعة تل أبيب، ونفّذه الدكتور كفير دولف (Kfir Dolev) ضمن أبحاث ما بعد الدكتوراه. والمؤلفون الآخرون هم أديتيا كوسيك ومايكل واي لي وجي برونو دي لوكا ونوريا كوهين ونواه غودمان.
أعلنت جامعة تل أبيب العمل في بيان يوم الأربعاء 4 نوفمبر 2026. ويظهر سجل arXiv أن الورقة قُدّمت في 24 سبتمبر 2026، أي قبل التغطية الإخبارية بنحو ستة أسابيع.
لماذا يهم
تتعلم النماذج الكبرى اليوم من أكوام ضخمة من النصوص والصور التي صنعها البشر وجرى انتقاؤها لها. ويرى المؤلفون أن نموذجًا قادرًا على إنتاج مادة تدريب مفيدة بنفسه سيكون محدودًا بالقدرة الحاسوبية، لا بالمعرفة البشرية.
تصف بعض وسائل الإعلام، ومنها يديعوت أحرونوت (Ynetnews) وذا ميديا لاين (The Media Line)، العمل بعبارات واسعة مثل نماذج تعلّم نفسها. أما ليفين وملخص arXiv فيستخدمان وصفًا أضيق: إثبات مفهوم بنماذج صغيرة. وتقول بعض التغطيات إن البيانات صُنعت من الصفر أو بنماذج ذكاء اصطناعي أخرى، وهذا أوسع من وصف الورقة نفسها: برامج تعمل على آلة تورنغ العامة، وهي حاسوب نظري يستطيع تشغيل أي برنامج.
ويقول الباحثون إن الطريقة لا تستطيع تعليم حقائق عن العالم الحقيقي دون التعرض لمعلومات منه. ويرون أنها قد تساعد الأنظمة المستقبلية على التعلم بكفاءة أكبر حين تواجه بيانات حقيقية. والاختبارات حتى الآن على نماذج صغيرة، وتصف الورقة العمل بأنه خطوة أولى.